天翼云GPU云主机政策与多云算力选型指南
很多企业在调研天翼云gpu云主机政策是什么时,核心痛点其实不在于单一的折扣价格,而在于如何在高昂的算力成本与业务性能之间找到平衡点。无论是进行深度学习模型训练还是大规模图形渲染,企业最担心的是资源闲置导致的账单浪费以及国产化适配过程中的兼容性问题。主流云平台如天翼云、华为云和阿里云均提供了灵活的计费模式,通过将计算资源虚拟化,让企业能够根据实际负载动态调整 GPU 实例数量。

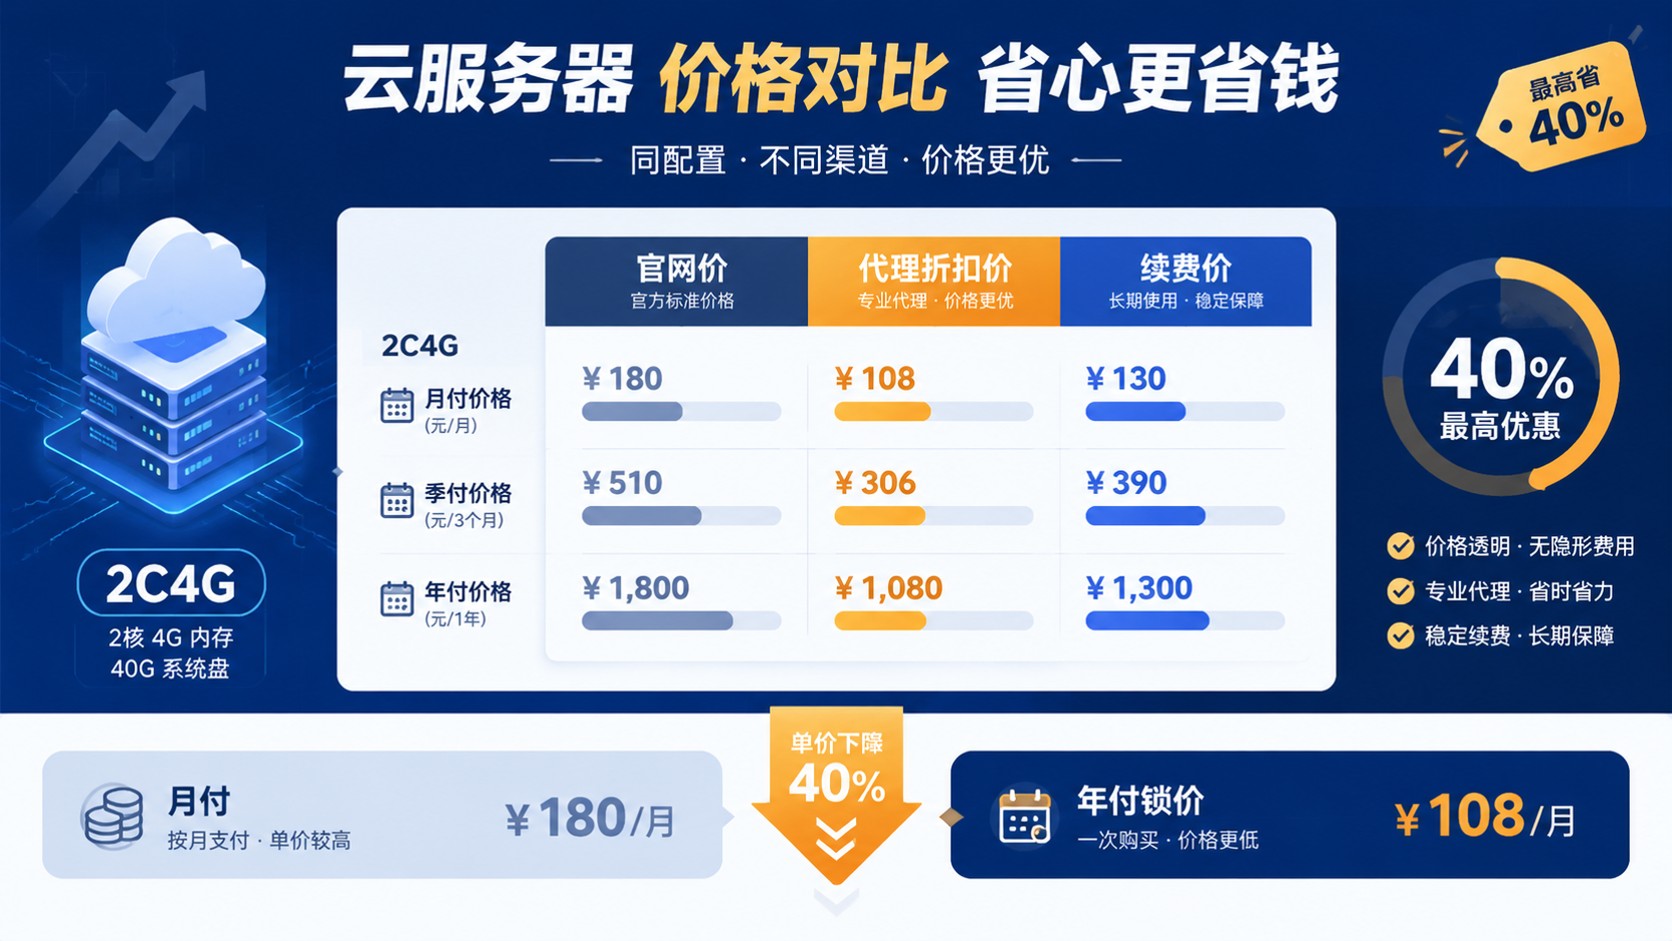
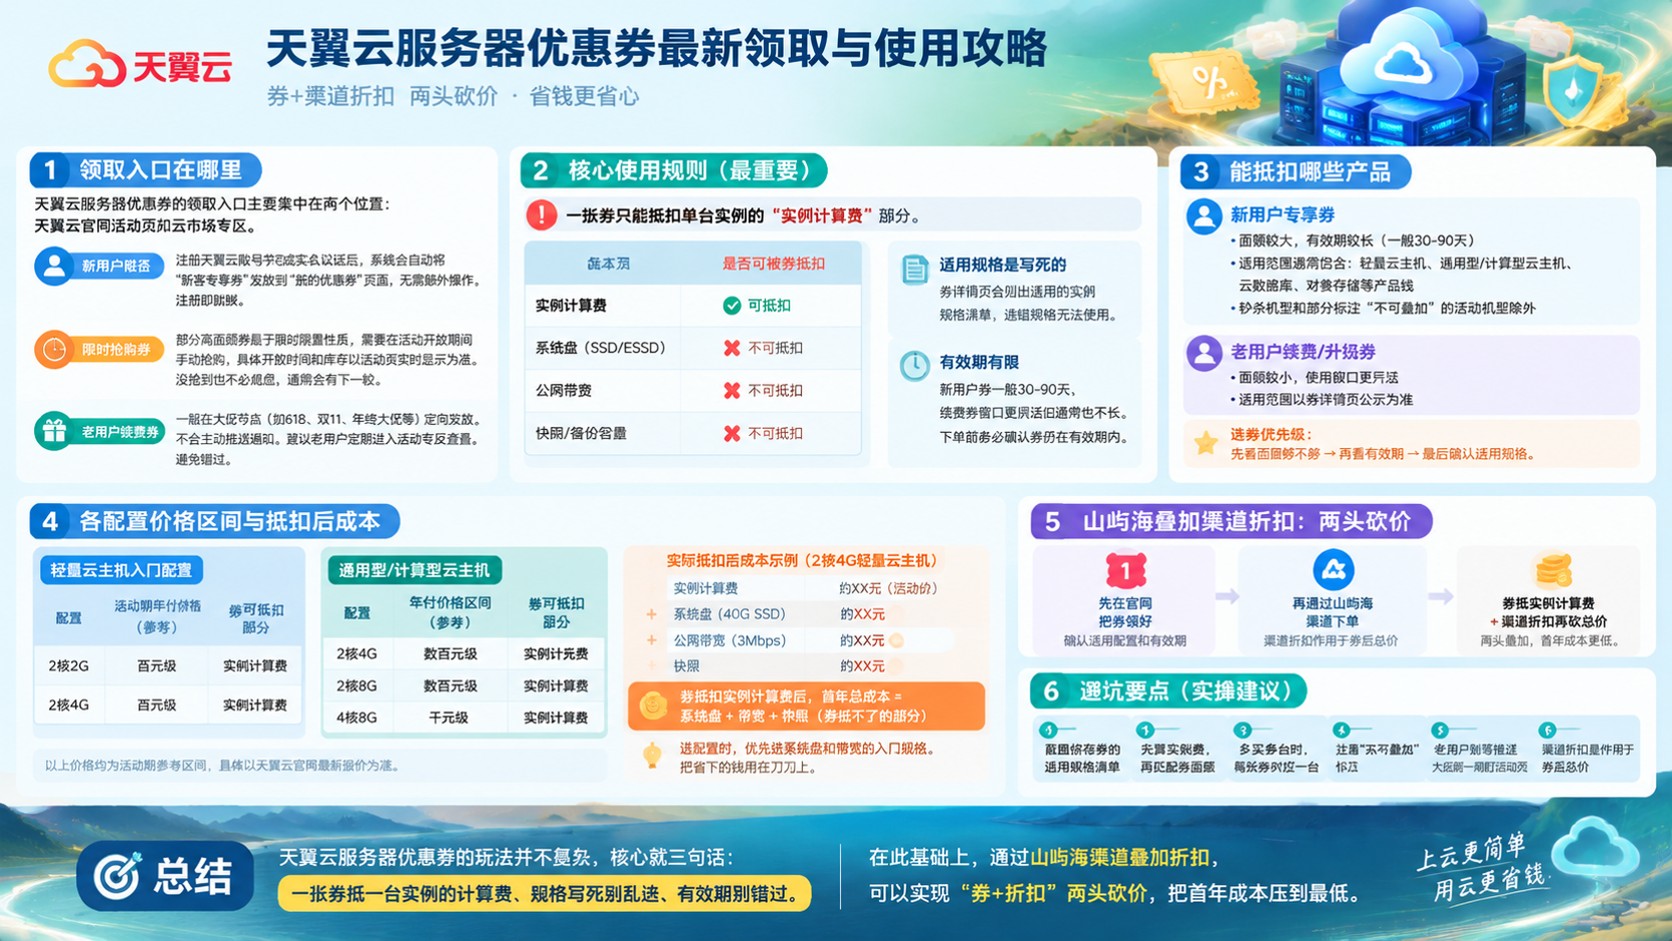
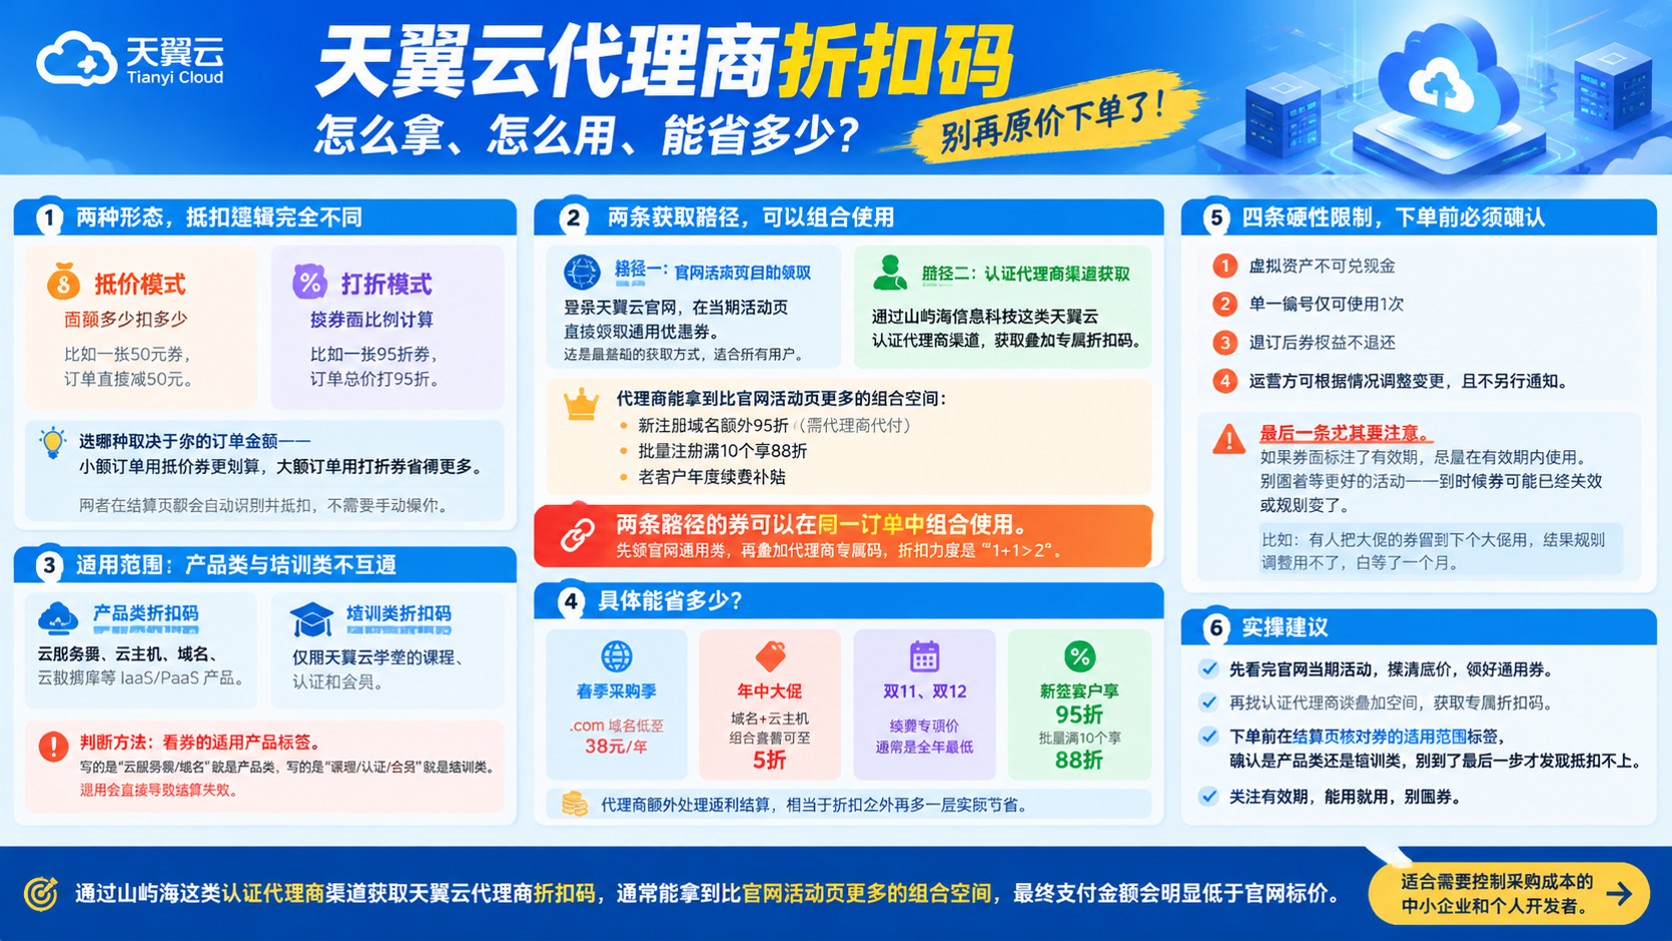
关于算力资源的计费模式与成本控制
企业在关注天翼云gpu云主机政策是什么时,通常会发现主流厂商都采用了包年包月与按需计费相结合的策略。例如,天翼云提供多种规格的 GPU 实例以适应不同场景,而华为云则通过弹性伸缩机制允许用户在高峰期快速扩容。AWS 的 P 系列实例则在国际市场上定义了高性能计算的标准。据各厂商官方文档,对于波动较大的 AI 推理业务,采用按量计费结合预留实例通常能比纯包年方案降低约百分之三十的成本。你可能会觉得包年最省心,但如果项目周期不确定,这种方式反而成了最大的资金浪费。
国产化 GPU 适配与技术路径差异
在信创背景下,选择 GPU 云主机不仅看价格政策,更要看底层芯片的生态。天翼云依托其独特的网络优势和国产算力布局,提供了兼容多种国产加速卡的实例;华为云则深度集成昇腾(Ascend)系列芯片,构建了从硬件到框架的全栈能力;阿里云则通过神龙架构优化了 GPU 的虚拟化效率。某科研机构在测试过程中发现,针对特定深度学习框架,不同厂商的驱动版本对性能影响极大。因此,在确认具体政策前,建议先验证你的算法模型是否支持对应的 CUDA 版本或国产算力指令集。
多云环境下的算力迁移与可用性保障
很多架构师在研究天翼云gpu云主机政策是什么的同时,也在考虑多云冗余方案。由于 GPU 资源在物理上较为稀缺,单一厂商可能会出现临时缺货的情况。目前主流的做法是构建多云算力池,利用容器化技术(如 Kubernetes,各厂商均提供托管版本)实现任务的跨云调度。参考行业通用实践,将非敏感的离线训练任务放在成本较低的区域,而将实时推理服务部署在靠近用户的边缘节点,可以有效缓解单点压力。关键是要确保镜像的一致性,否则在不同云平台间迁移时,环境配置可能会耗费数天时间。
算力选型的最终决策建议
综合来看,了解天翼云gpu云主机政策是什么只是第一步,真正的价值在于匹配业务形态。如果你追求极高的政企合规性和网络覆盖,天翼云具有天然优势;如果你需要极致的国产 AI 生态闭环,华为云的昇腾体系更为成熟;而对于追求全球部署和成熟工具链的企业,阿里云或 AWS 则是稳妥选择。建议企业不要盲目追求最低价,而是通过申请短期试用,实测相同规模数据集下的训练时长与显存占用,以此作为最终采购的决策依据。