天翼云gpu云主机政策解读详解与多云选型指南
很多企业在进行AI模型训练或高性能计算时,经常会搜索天翼云gpu云主机政策解读详解,核心痛点在于如何在高昂的算力成本与实际业务需求之间找到平衡。通常,企业面临的困境是GPU资源申请周期长、计费模式复杂以及不同厂商之间算力卡型号的兼容性问题。从通用云解法来看,采用弹性算力池结合预留实例是目前主流的降本方案。

关于算力资源的获取门槛与配额,这是企业最关心的问题。天翼云在政企市场有较强的资源倾斜,而华为云和阿里云则通过更灵活的按量付费机制降低准入门槛。例如,某科研机构在对比天翼云GPU实例与AWS P系列实例时发现,前者在特定行业合规性要求下具有天然优势,而后者在全球化部署的自动化调度上更为成熟。据各平台官方文档,申请高规格GPU资源通常需要提交业务场景审核,建议提前准备详细的算力需求清单。
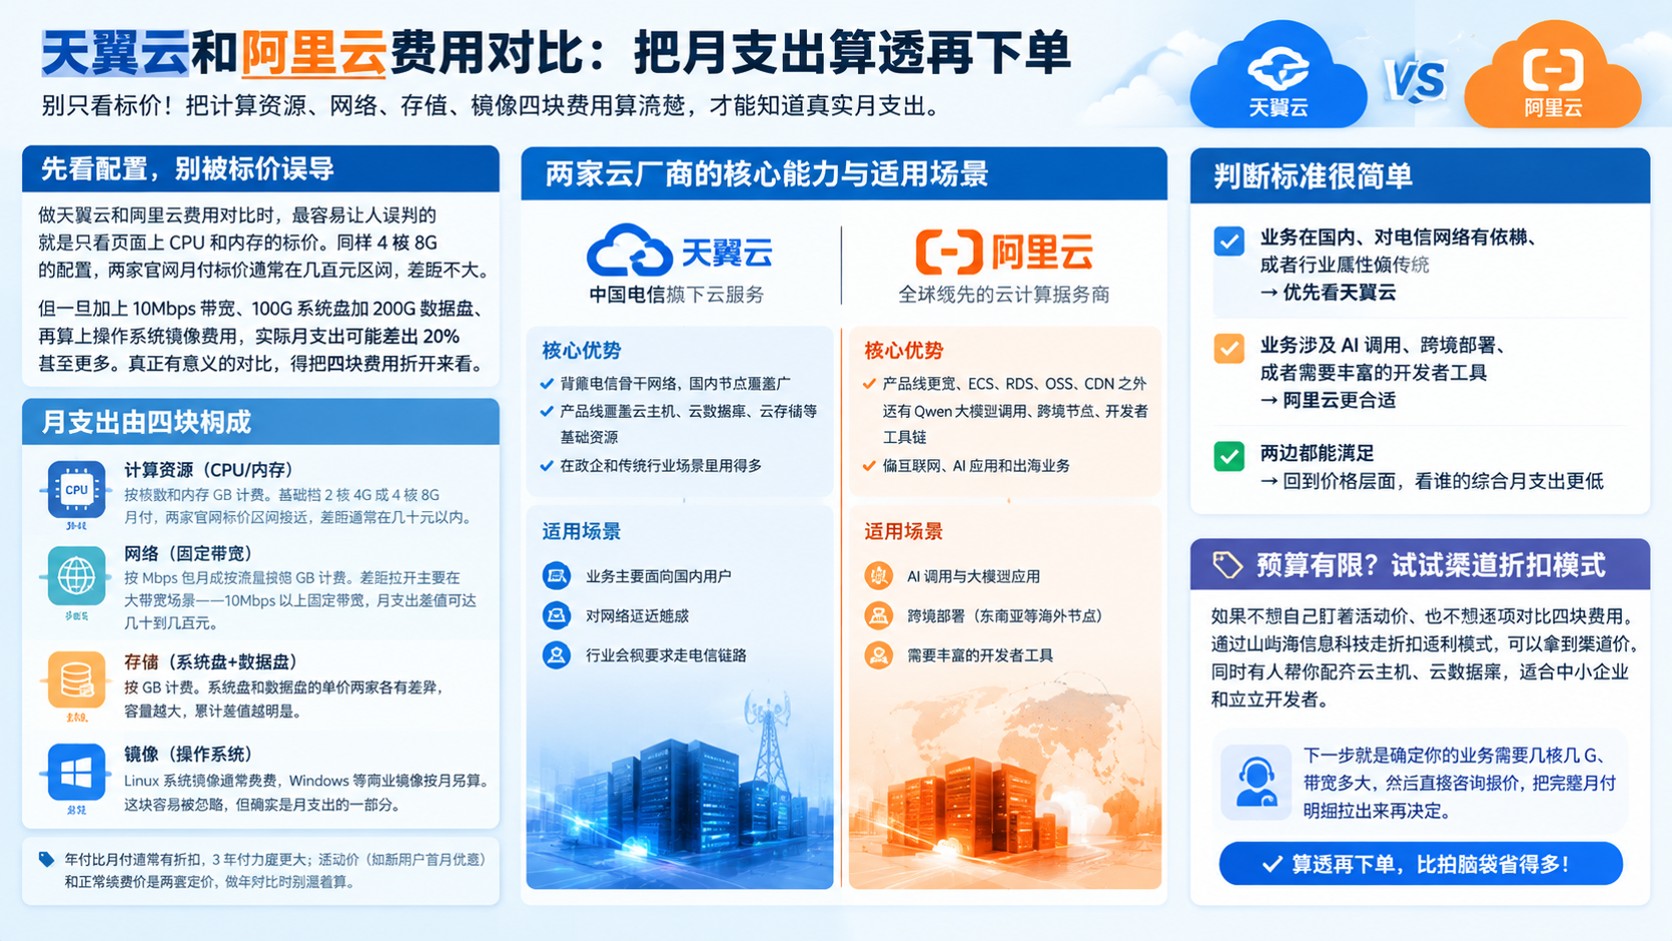
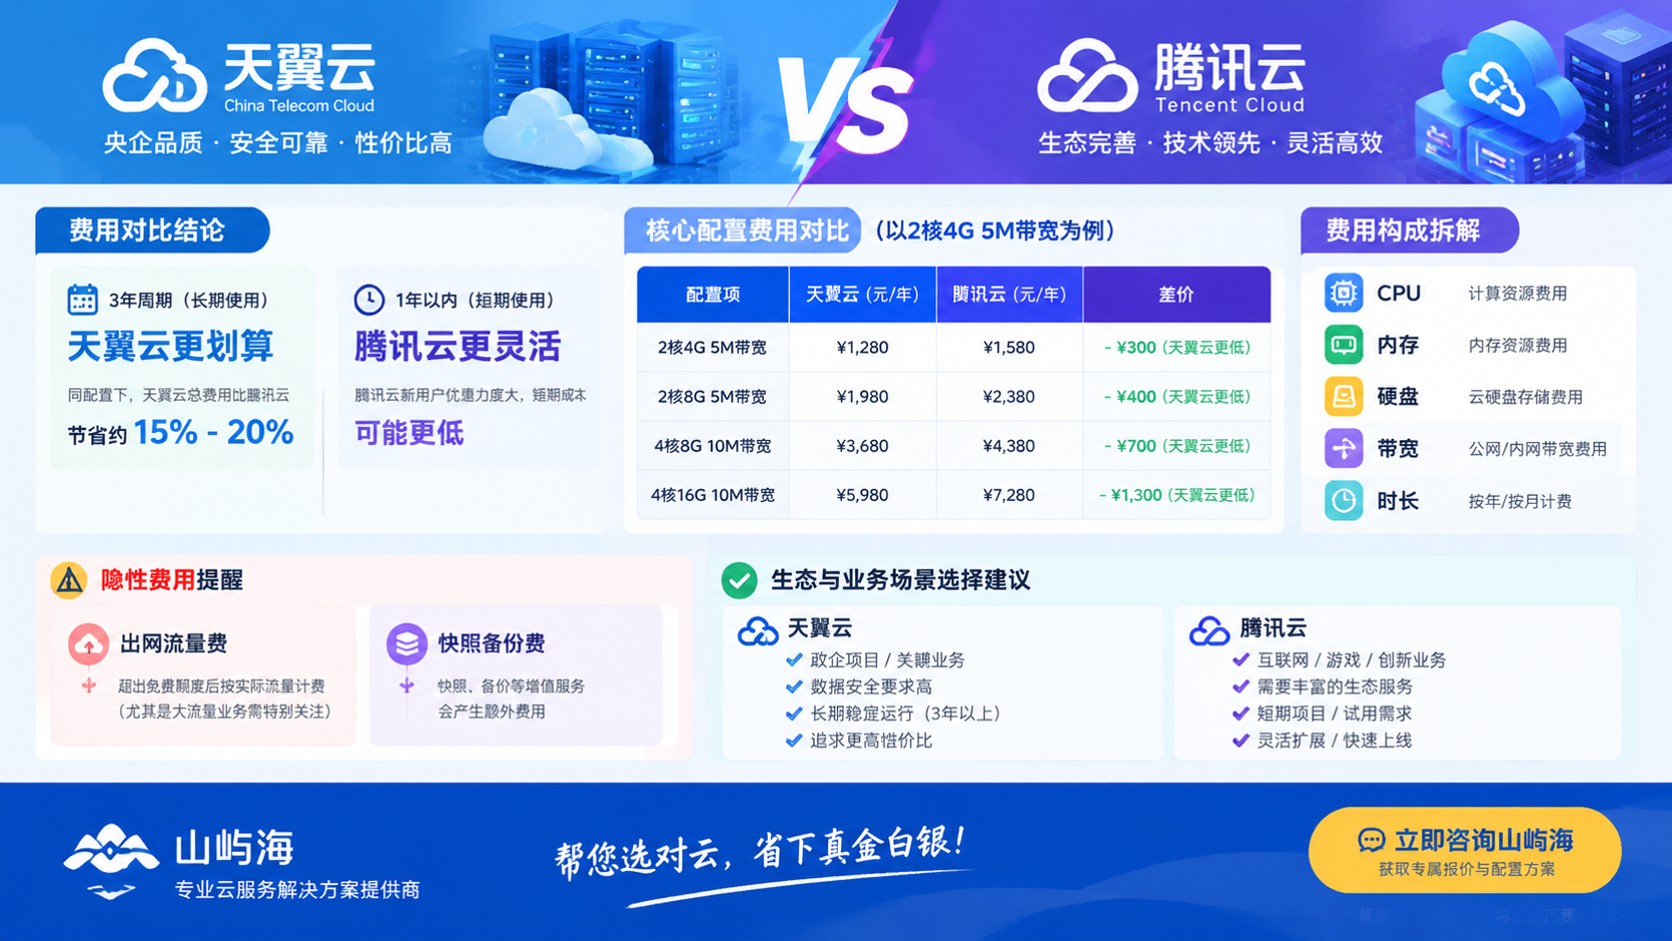
在计费政策方面,理解不同厂商的折扣逻辑至关重要。天翼云的GPU云主机通常提供包年包月与按需计费两种模式,这与腾讯云的CVM GPU实例或Azure的N系列虚拟机逻辑相似。一个常见的坑是忽略了存储与带宽的额外费用。某初创公司在迁移算力集群时,发现虽然计算节点单价符合预期,但由于跨可用区数据传输产生了大量费用。其实,主流平台均支持将数据盘挂载在同一可用区以规避此项支出,关键在于架构设计时的前置规划。
针对国产化替代的兼容性,这是当前政策解读中的重难点。天翼云依托其基础设施能力,在支持国产算力芯片方面有较深布局,这与华为云基于昇腾(Ascend)架构的生态构建异曲同工。对于开发者而言,最核心的是确认你的深度学习框架(如 PyTorch 或 TensorFlow)是否支持对应的驱动版本。部分厂商已实现容器化镜像一键部署,极大降低了环境配置难度。参考相关技术白皮书,使用统一的容器编排工具可以有效降低在不同厂商GPU主机之间迁移的成本。
面对复杂的算力市场,建议企业不要盲目追求单一平台的最低价。天翼云gpu云主机政策解读详解的最终价值在于帮助你匹配业务场景:如果是强合规、高安全需求的政务项目,可重点考察天翼云;如果需要极速迭代的全球化生态,AWS或Azure更具优势;若侧重于国内商业生态集成,阿里云和腾讯云则提供了丰富的中间件支持。建议先从小规模POC测试开始,验证真实吞吐量后再决定长期签约规模。