企业如何高效筛选天翼云GPU云主机资源与服务渠道
很多企业在寻找天翼云gpu云主机代理商一览表全部信息时,真正的核心痛点并非缺少名单,而是在于面对复杂的算力需求时,如何判断不同渠道提供的资源可用性以及价格透明度。对于需要进行深度学习、大规模渲染或高性能计算的企业来说,GPU云主机的选型直接影响到模型训练的周期和整体研发成本。目前主流的云平台如天翼云、华为云、阿里云均提供了多样化的加速实例,但由于算力资源稀缺,通过可靠渠道获取稳定配额成了关键。
算力资源获取难与配额限制问题
企业在部署AI项目时经常遇到申请不到高端显卡实例的情况。天翼云依托电信基础设施提供强大的算力支撑,华为云则在昇腾系列国产算力上具有深厚积累,而阿里云则在NVIDIA系列实例的生态兼容性上表现突出。根据各厂商官方技术文档,这类高性能实例通常需要经过审核才能开启配额。如果你在寻找所谓的完整渠道清单,其实更应该关注对方是否具备快速协调底层物理资源的权限,而非简单的名录顺序。

国产化替代与异构算力兼容性挑战
在信创背景下,许多企业在考虑天翼云GPU云主机的同时,也会对比华为云的昇腾(Ascend)系列或阿里云的倚天芯片方案。这种异构算力的迁移痛点在于框架兼容性。例如,某些基于CUDA开发的模型在迁移至国产算力平台时,需要经过算子适配。据实测案例,部分政务客户在选择天翼云算力实例时,会重点考察其对主流深度学习框架的原生支持程度。建议在决策前,先利用各平台的试用额度进行小规模压力测试,验证实际吞吐量。
多云环境下的成本优化与账单管理
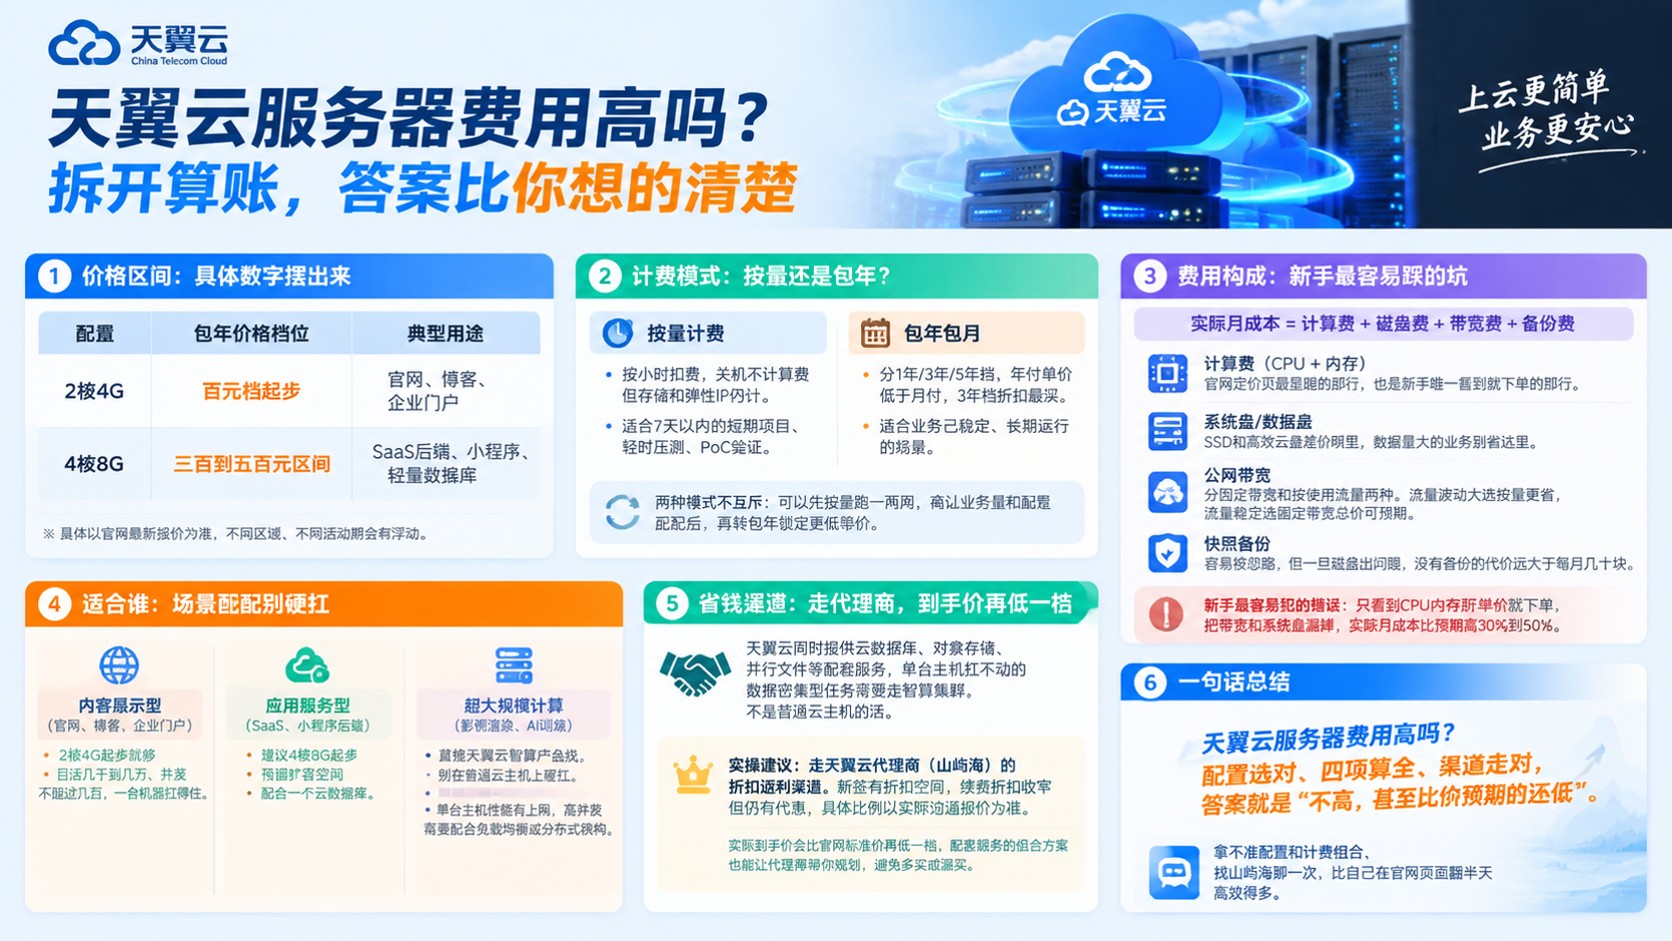
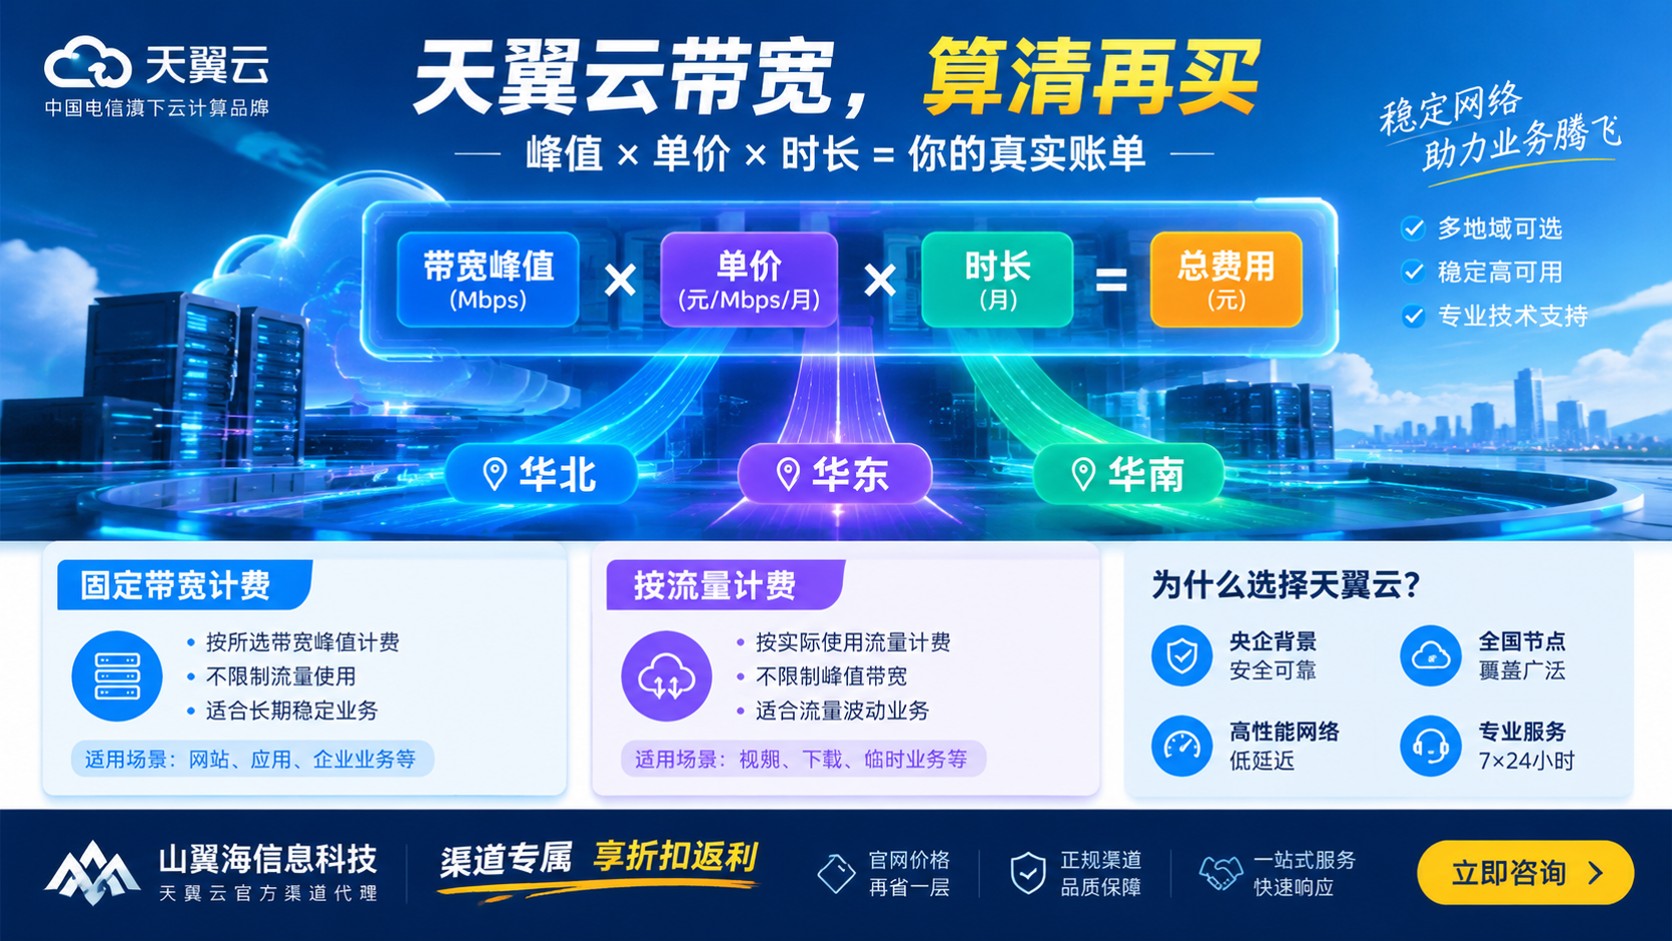
无论你通过何种方式获取天翼云的GPU资源,成本失控始终是架构师的噩梦。GPU实例的单价远高于通用计算型实例,且计费模式复杂。AWS的按需与预留实例、腾讯云的竞价实例以及天翼云的包年包月方案各有侧重。一个典型的企业痛点是:在模型训练峰值期需要大量资源,而在推理阶段仅需少量维持。此时,采用混合计费模式能有效降低开支。参考主流云厂商的成本管理白皮书,合理配置弹性伸缩策略可使年度算力成本降低三成左右。
关于算力服务选型的中立建议
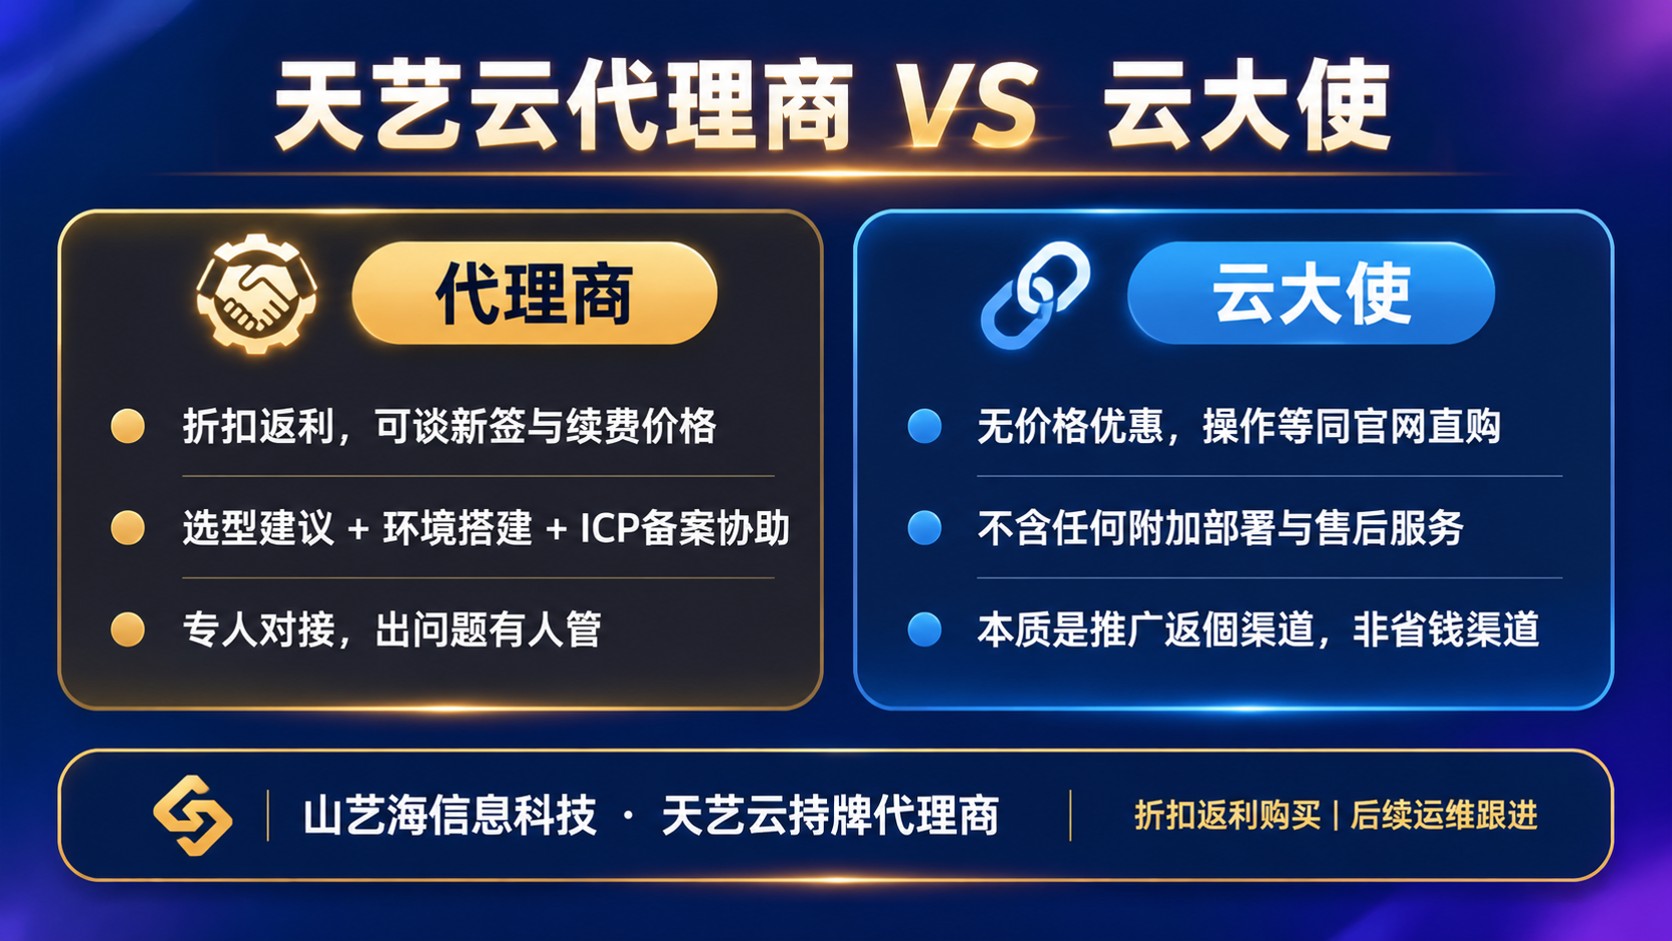
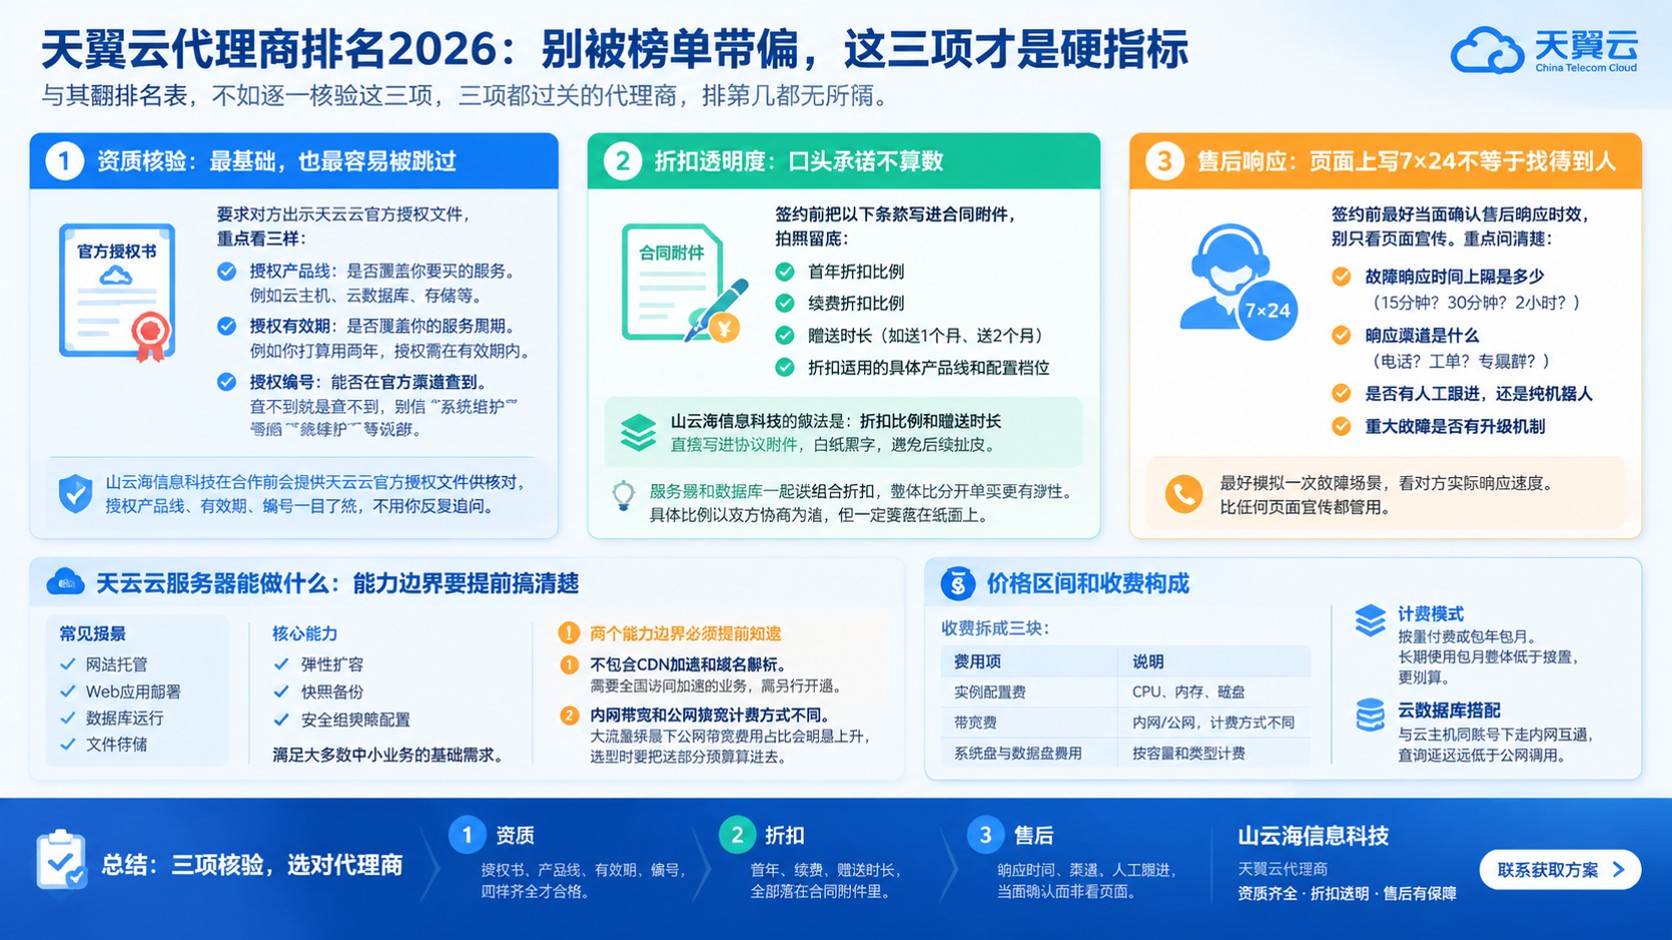
面对市场上繁多的服务提供方,与其执着于一份静态的代理商一览表,不如建立一套动态的评估体系。首先确认该渠道能否提供原厂级别的技术支持,其次验证其在特定区域(如东中国区、南中国区)的资源储备情况。无论是选择天翼云的稳定性,还是华为云的国产生态,亦或是阿里云的便捷性,最终的衡量标准应是:单位成本下的算力产出比以及迁移时的停机时间。建议企业结合自身业务的实时性要求,在两到三家主流平台之间构建多云备份机制,以规避单一供应商的资源风险。