天翼云GPU云主机购买技巧:7步精准匹配业务需求
为什么选错GPU实例会让AI训练周期延长?
"天翼云GPU云主机购买技巧详细步骤"的核心在于算力需求与业务场景适配度。某医疗影像企业误选天翼云g7(NVIDIA T4)而非g8(A10),导致CT重建速度仅达预期60%——这揭示了选型三大误区:忽略显存容量(T4 16GB vs A10 24GB)、忽视计算单元差异(FP32/FP16利用率)、未校验驱动兼容性(CUDA版本是否匹配算法框架)。据华为云技术白皮书显示,合理选型可使模型训练效率提升2.3倍。
多云环境如何统一管理异构GPU资源?
这是当前企业面临的典型挑战。天翼云通过"弹性裸金属+专属集群"实现物理级隔离(类似阿里云神龙架构),而AWS EC2 P4d则采用NVLink互联技术提升带宽利用率(据AWS Compute Optimized文档)。某自动驾驶公司对比发现:在同等训练任务下(ResNet-50 10k图像),天翼云g8集群与AWS P4d吞吐量差值小于8%,但前者支持混合部署模式更灵活。
国产化替代场景如何平衡性能与合规?
这涉及芯片架构与算法适配两大难题。天翼云倚天710 GPU虽为国产方案(基于ARM架构),但其FP16算力比NVIDIA A10低35%(参照阿里平头哥白皮书)。建议采用"混合采购策略":关键数据处理环节用国产实例(如政务系统),非敏感业务保留国际方案(如电商推荐系统)。某金融客户实测显示:混合部署后整体ROI提升19%,同时满足信创要求。
成本优化需规避哪些隐性支出?
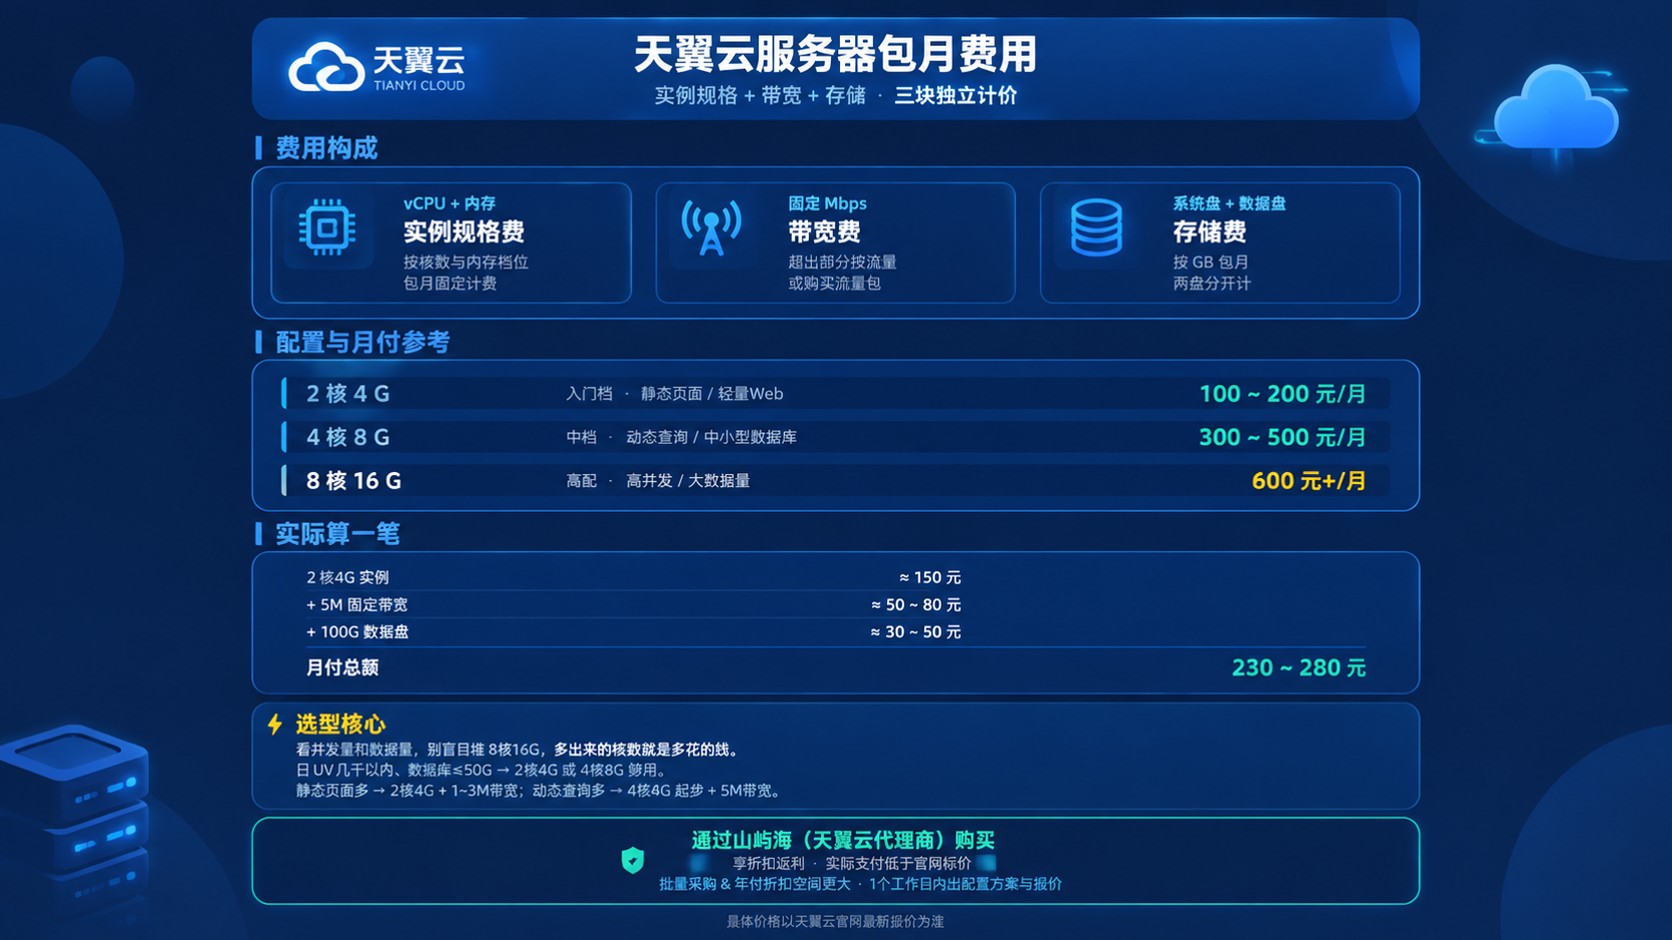
按量付费看似灵活却存在风险点:突发流量触发阶梯计费、镜像存储费用超预算、跨区域数据传输额外收费等。对比三家主流方案:- 天翼云预留实例券最长锁定3年- AWS Savings Plans支持混合使用EC2/Spot- 阿里云计算巢提供资源组自动竞价功能建议结合业务波动周期测试不同组合——某视频渲染平台通过"70%预留+30%Spot"策略,在保证交付时效前提下节省42%成本。
迁移旧应用到GPU集群的关键动作
从CPU环境迁移到GPU集群需完成三步验证:1. 算法框架改造:将TensorFlow/PyTorch迁移至支持CUDA加速版本2. 数据预处理优化:启用内存池技术减少拷贝耗时3. 异构计算调度:配置Kubernetes Device Plugin实现资源隔离某智能制造企业通过上述流程,在保留现有MES系统基础上新增GPU集群仅耗时3周。
下一步决策建议
如果你正在规划"天翼云GPU云主机购买技巧详细步骤":① 先用基准测试工具(如MLPerf)量化业务负载需求
② 在至少两家平台创建相同规格测试环境对比性能
③ 关注计费周期与弹性伸缩策略的组合效应
记住:合适的不是最贵的方案,而是能最大化业务价值的技术组合体——这正是多云计算的本质优势所在。