天翼云大数据推荐怎么选才不踩坑?
为什么你的大数据平台总是“跑不动”?
如果你也在问“天翼云大数据推荐怎么用”,那么你可能已经遇到了常见的性能瓶颈。大数据平台的核心在于数据处理能力与资源调度效率,而天翼云推荐的解决方案往往基于其分布式计算架构(如Flink、Spark on YARN)。但你知道吗?华为云MRS、阿里云EMR、AWS EMR同样提供类似的托管服务,关键在于你的业务负载类型——是实时流式计算还是离线批处理?选错模型,成本翻倍不说,响应速度也会让客户流失。
能便宜多少?成本控制才是大数据项目的命门
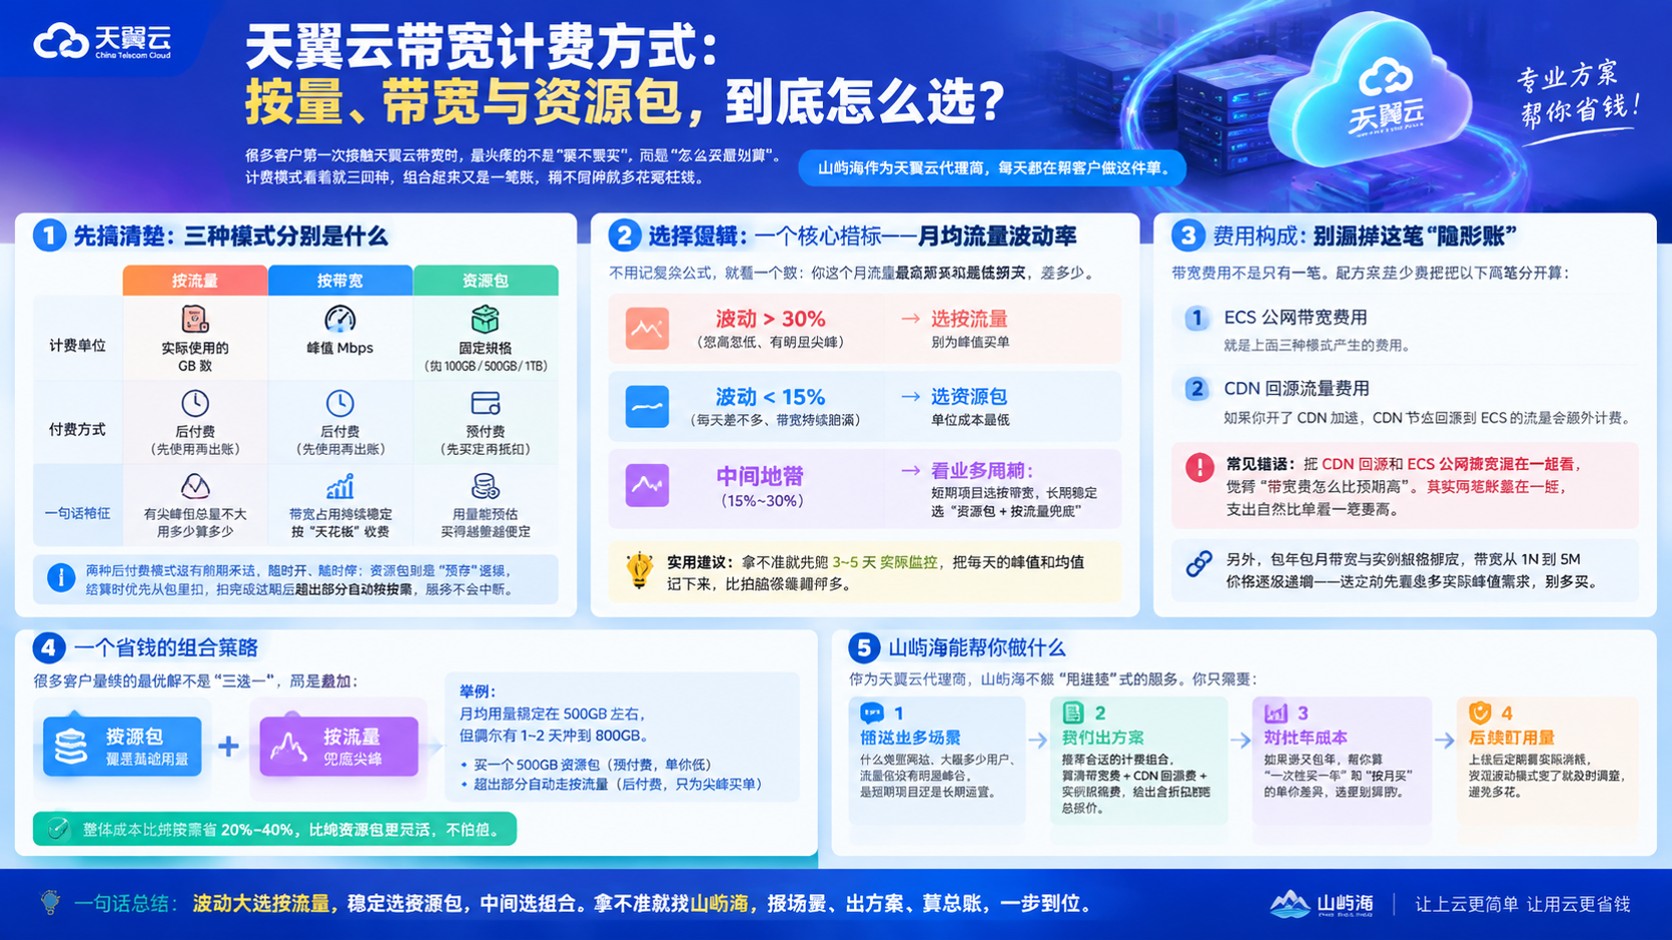
“天翼云大数据推荐能省多少钱?”这是CIO最常问的问题。据天翼云官方文档,其按量计费模式在低峰期可节省30%成本,但如果你的数据处理是周期性任务(如每日ETL),那么预留实例或竞价实例会更划算。相比之下,AWS EMR支持Spot Fleet自动调度,Azure Databricks则强调按使用量计费的弹性。建议你先梳理数据任务的高峰时段与持续时长,再对比多平台的计费模型。
国产化替代怎么选?
这不仅是技术问题,更是政策问题。“天翼云大数据推荐是否支持国产芯片?”目前天翼云已推出基于飞腾CPU+麒麟OS的信创方案,并兼容鲲鹏生态。而阿里云则在倚天710上做了深度优化,华为云MRS也适配鲲鹏架构。某金融客户测试发现,在国产芯片上部署Spark任务时,内存管理效率比x86平台提升15%——当然前提是你的应用和依赖库都完成了适配。
多云迁移时如何避免停机?
如果你考虑从AWS或阿里云迁移到天翼云大数据平台,“数据怎么迁移”是一个绕不开的话题。主流做法是使用Apache Nifi或DataX进行ETL转换与传输,并结合Kafka做缓冲队列。天翼云自身也提供了数据迁移工具链(DTS),但要注意跨平台Schema差异和分区策略兼容性。某制造企业采用分阶段迁移法,在原有集群上运行新任务的同时逐步切换入口流量,最终实现零停机切换。
多厂商支持是否真的可靠?
“天翼云大数据推荐能不能支持混合部署?”答案是肯定的。目前主流厂商均支持Kubernetes与YARN混布架构,使得你可以将部分任务部署在本地IDC或私有云中,而计算密集型任务则放到公有云集群上运行。例如华为云MRS支持OpenLooKeng混合部署、阿里云EMR可以对接Hadoop生态组件、AWS EMR甚至允许自定义JAR包运行环境。关键是你要有一个统一的调度层(如Airflow)来协调不同平台的任务依赖关系。
下一步怎么做?
如果你还在纠结“天翼云大数据推荐怎么选”,建议你先列出当前数据平台的痛点清单:是延迟高?还是扩展性差?或者成本失控?然后根据这些指标去选择对应的资源模型(如实时流式选Flink on Kubernetes、批处理选Spark on YARN)。记住:一个好的大数据平台不是最贵的,而是最懂你业务节奏的那个。